논문 읽기와 연구 노트에 BibGenie를 활용하는 방법
Zotero AI 플러그인 BibGenie를 활용한 나의 연구 워크플로: 논문 검색, 비판적 읽기, 출처 검증, 연구 비교, 문헌 탐색, 연구 노트 저장.
문헌 고찰에서 새 논문을 읽는 것은 작업의 일부일 뿐입니다. 중요한 질문을 다룬 논문을 기억하면서도 바로 찾지 못하거나, 여러 연구가 비슷한 용어를 쓰지만 다른 대상을 평가하거나, 그럴듯한 요약이 원문에 돌아가 보니 중요한 단서를 빠뜨린 경우를 더 자주 겪습니다.
제가 Zotero AI 플러그인의 도움을 받고 싶은 일은 이런 작업입니다. 구체적인 논문, 연구 질문, 근거를 차근차근 검토하는 것입니다. 저에게 BibGenie의 가치는 질문, 검색, 출처 검증을 같은 Zotero 환경 안에 두어 답변이 추가 읽기의 출발점이 되게 하는 데 있습니다.
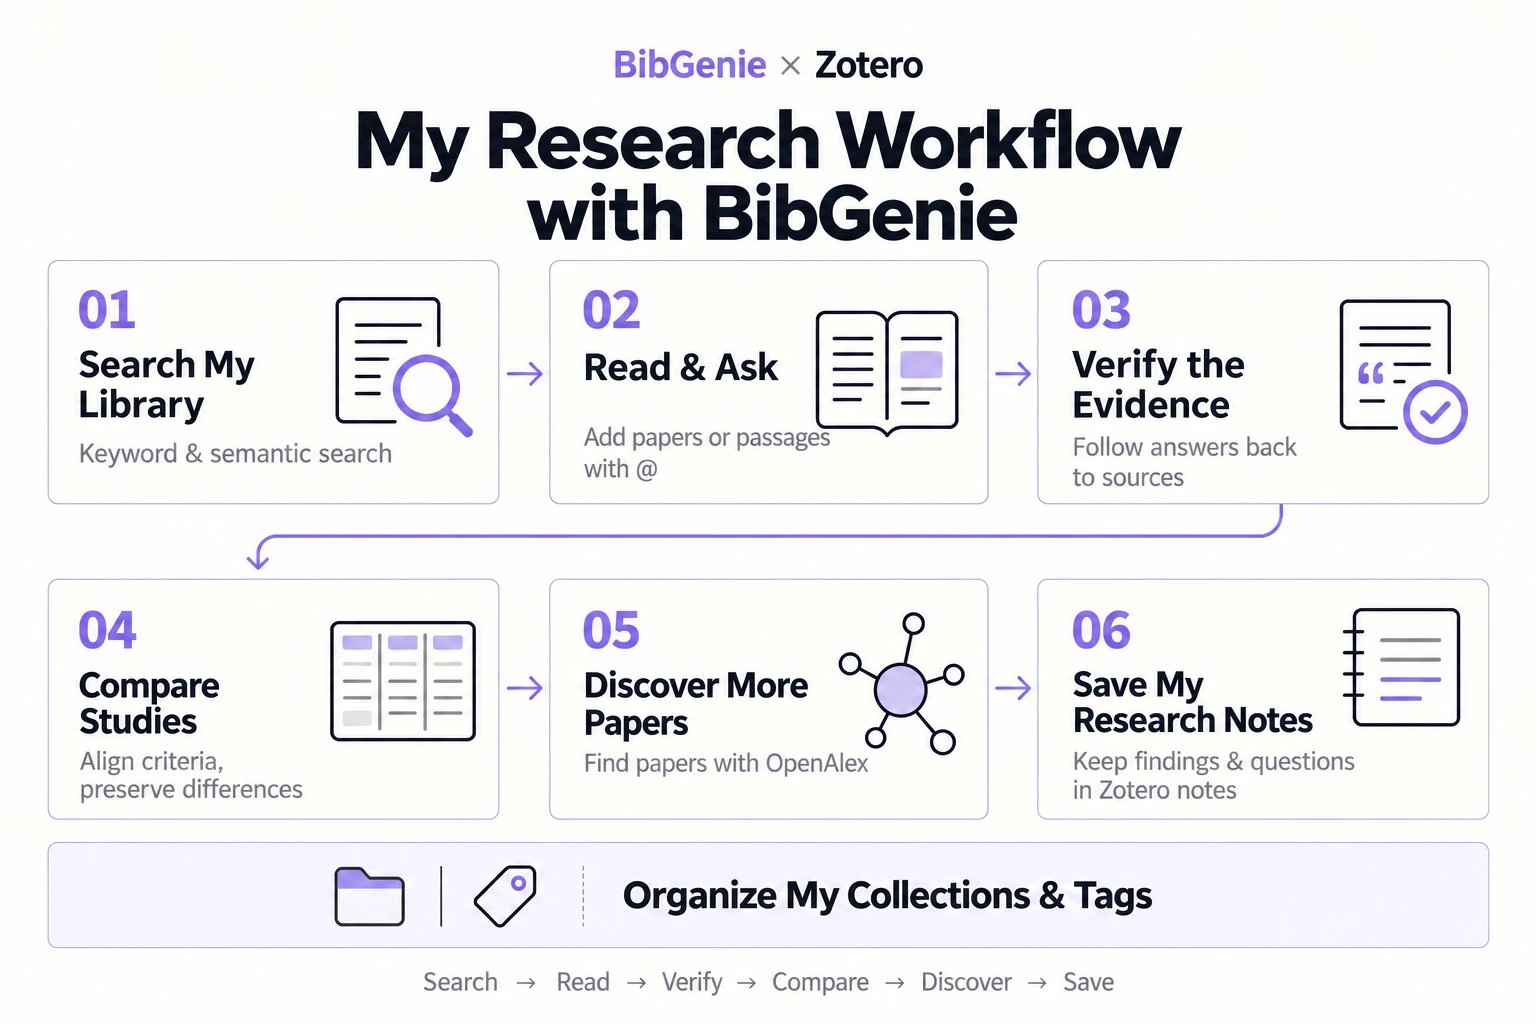
연구 질문에서 독서 노트까지. 컬렉션과 태그는 라이브러리가 커짐에 따라 별도로 관리합니다.
이 글에 대하여
BibGenie 팀이 작성한 이 글은 팀원의 연구 관점에서 워크플로를 소개합니다. 영어판이 번역의 원문입니다. 검색 증강 생성에서 답변의 충실도를 평가하는 문제를 일관된 예제로 사용하므로 프롬프트를 자신의 프로젝트에 맞게 조정하세요. 예제는 완료된 연구 실험을 보고하거나 특정 검색 결과나 발견을 전제하지 않습니다.
1. 연구 질문에서 시작해 이미 보유한 논문 찾기
주제를 탐색할 때 저는 보통 Zotero에 이미 있는 자료부터 살펴봅니다. 여기서의 질문은 **검색 증강 생성(RAG) 시스템은 답변이 검색된 근거로 뒷받침되는지를 어떻게 평가하는가?**입니다.
faithfulness로 검색하면 일부 논문을 찾을 수 있지만 관련 연구는 groundedness, attribution, citation correctness를 쓸 수도 있습니다. 이 용어들이 반드시 같은 뜻은 아니며 관련 연구가 다른 어휘를 사용할 수도 있습니다. 그래서 키워드 검색과 의미 기반 검색을 결합해 후보 논문을 찾고 각 논문이 질문과 어떻게 관련되는지 확인합니다.
First, search my Zotero library for papers relevant to this question:
How do RAG systems evaluate whether generated answers are supported by retrieved evidence?

Combine keyword and semantic search. Consider faithfulness, groundedness,
attribution, and citation correctness, without assuming they mean the same thing.

List titles, years, and relevance based on titles and abstracts.
Identify information drawn from abstracts; do not present it as a verified full-text finding.
Search saved material only. Do not search external sources or modify my library.
이 시점에 원하는 것은 읽을 논문의 후보 목록입니다. 초록을 확인해 사실적 정확성, 제공된 근거와의 일관성, 인용의 정확성을 구분합니다. 이를 구분하지 않으면 나중에 비교할 공통 기반이 없을 수 있습니다.
자동으로 업데이트되는 의미 기반 색인
BibGenie는 의미 기반 색인을 자동으로 구축하고 업데이트하므로 보통 직접 관리하지 않고 연구 질문을 중심으로 바로 검색할 수 있습니다. 색인은 주로 항목의 제목과 초록을 이용해 표현은 달라도 주제가 관련된 논문을 찾으며 PDF 원문 전체를 의미 기반으로 검색하는 것은 아닙니다. 저는 결과를 후보로 취급하고 방법이나 발견을 판단하기 전에 원문을 읽습니다. 작동 방식은 의미 기반 색인을 참고하세요.
2. 특정 논문을 대화에 추가하고 방법과 결과 검토하기
논문을 고르면 BibGenie 입력창에 **공백 다음 @**를 입력하고 제목을 입력한 뒤 일치하는 결과를 선택합니다. 논문이 컨텍스트 블록으로 나타납니다. 이어서 질문하거나 논문과 노트를 더 추가할 수 있습니다.
먼저 리더를 열 필요는 없습니다. 방법이나 실험 결과를 논의하려면 선택 항목에 읽을 수 있는 원문이 첨부됐는지 확인합니다. 제목과 초록 같은 메타데이터만 있다면 그 자료가 뒷받침할 수 있는 범위로 질문을 제한합니다. 자료를 추가하는 다른 방법은 컨텍스트 추가를 참고하세요.
바로 문헌 고찰을 요청하기보다 먼저 한 연구의 논리를 풀어봅니다. 연구 질문, 방법이 평가하는 대상, 실험이 뒷받침하는 발견, 한계를 살펴봅니다.
Using the full text of the paper I added, summarize:
1. The research question and how the authors define answer faithfulness or related concepts;
2. The unit of evaluation: an entire answer, sentence, factual claim, or citation;
3. The evidence used, annotation procedures, and evaluation metrics;
4. The experimental setup and main findings;
5. Limitations explicitly discussed by the authors.

Provide source citations for key statements so I can verify them.
Separate the authors' conclusions from your interpretation.
Mark anything the material does not specify as "Not specified."
이 개요는 읽기에 구조를 제공합니다. 이어서 해석에 영향을 주는 세부 사항을 질문합니다. 예를 들어 지표가 검색된 컨텍스트를 기준으로 사용한다면 그 컨텍스트의 정확성도 평가하는지 확인합니다. 그렇지 않다면 그 지표만으로 답변의 전반적인 사실적 정확성을 보장할 수 없습니다.
정의, 수식 주변 설명, 실험 세부 사항은 리더에서 해당 구절을 선택하고 채팅에 추가한 뒤 질문합니다. @로 논문을 추가하면 연구 전체를 논의할 수 있고 구절을 선택하면 특정 텍스트로 질문을 좁힐 수 있습니다. 같은 읽기 세션에서 두 방법을 모두 사용합니다.
3. 인용을 따라 출처로 돌아가 답변 확인하기
AI 요약을 읽을 때는 핵심 주장이 원자료로 뒷받침되는지에 집중합니다. 정의, 결과, 방법론적 한계를 노트에 반영하기 전에 출처로 돌아갑니다.
BibGenie는 가능한 경우 출처 인용을 제공합니다. 유효한 위치 정보가 있는 문서 인용은 자료와 해당 구절로 이동할 수 있게 합니다. 근거 인용은 Zotero 항목, 첨부파일, 노트 링크와 목적이 다릅니다. 객체 링크는 작업을 이어가는 데 도움이 되지만 클릭할 수 있는 논문 제목만으로 인접한 주장에 대한 근거가 성립하지는 않습니다.
다음을 확인합니다.
| 확인 대상 | 질문 |
|---|---|
| 정의 | 저자의 단서와 조건을 보존하고 관련 용어를 구분하는가? |
| 실험 결과 | 값, 데이터셋, 기준선, 실험 조건이 일치하는가? |
| 방법론적 한계 | 명시적으로 보고된 한계인가, AI의 추론인가? |
| 종합 | 출처가 그 판단을 뒷받침하는가, 추가 출처가 필요한가? |
답변이 서로 다른 질문을 혼동하면 수정을 요청합니다.
Recheck the definition at the cited passage.
Does it concern consistency with the supplied context, or factual correctness in the real world?
Explain the distinction using the source and revise your earlier summary accordingly.
Withdraw any unsupported claim, or clearly leave it as a question to verify.
인용은 출처로 가는 경로를 제공할 뿐 그 출처가 답변을 뒷받침하는지는 여전히 확인해야 합니다. 지원하는 출처 유형과 탐색 방법은 BibGenie 인용과 PDF 문단 인용을 참고하세요.
4. 공통 기준으로 연구 비교하기
핵심 논문 몇 편을 읽은 뒤 첨부파일과 기존 노트를 같은 대화에 추가해 비교합니다.
흔한 함정은 겉보기에 비슷한 결과를 직접 비교할 수 있다고 취급하는 것입니다. 두 논문이 점수를 보고하더라도 평가 단위, 근거 범위, 데이터셋이 다를 수 있습니다. 표는 자료를 정리하지만 연구 설계의 차이를 없애지는 않습니다.
비교 기준을 먼저 지정하고 ‘해당 없음’과 ‘보고되지 않음’을 남길 여지를 둡니다.
Using only the papers and reading notes I added, compare their evaluation designs.

Table columns: paper, concept definition, unit of evaluation, evidence source,
annotation or judgment procedure, datasets, main limitations, and source citations.

Use "Not reported" for missing information and "Not applicable" where appropriate.
Do not fill gaps or directly rank scores from different datasets or experimental settings.

After the table, list:
1. Commonalities supported by the available material;
2. Aspects that cannot yet be compared directly;
3. Questions I need to investigate in the full texts.
종합하기 전에 해석에 영향을 줄 수 있는 셀을 검증합니다. 어떤 논문은 초록이나 노트만 있다면 비교에서도 그 한계가 명시돼야 합니다.
독서 노트에서도 저자가 보고한 내용, AI의 요약, 나 자신의 해석을 구분합니다. 나중에 문헌 고찰을 작성할 때 잘 다듬어진 요약을 최종 결론으로 취급하는 대신 근거를 다시 살펴볼 수 있습니다.
5. OpenAlex로 라이브러리 밖까지 검색 확장하기
로컬 라이브러리는 제가 수집한 자료이지 주제에 관한 모든 연구가 아닙니다. 초기 읽기 후에는 OpenAlex로 최신 논문을 찾고 관련 출발 논문 주변의 인용 관계를 탐색합니다.
로컬 결과와 외부 결과를 분리하라고 명시적으로 요청합니다. 학술 레코드를 찾는 것과 논문을 읽는 것은 다릅니다.
Use OpenAlex to find additional research on evaluating answer faithfulness in RAG.
Start with at most 10 candidate records published since 2025.

List titles, years, publication venues or sources, and DOIs or other available identifiers.
Explain relevance based on available metadata; flag insufficient information.

Distinguish these records from the Zotero papers retrieved in this conversation.
Identify duplicates you can confirm, and separately list uncertain matches.
Do not import anything yet.
유망한 논문은 그 논문을 인용한 연구, 그 논문이 참조한 연구, 관련 레코드를 물어봅니다. 인용 수는 탐색에 참고할 수 있지만 품질이나 읽기 우선순위를 그것만으로 판단하지 않습니다.
OpenAlex는 주로 학술 메타데이터와 인용 관계를 제공합니다. 방법이 제 프로젝트에 맞는지 평가하려면 원문을 확보하고 읽어야 합니다. 제목, DOI, 범위를 확인한 뒤 Zotero로 가져올 후보를 정하고 읽기와 검증을 이어갑니다.
이는 탐색적 검색입니다. 체계적 문헌 고찰에는 적절한 데이터베이스 선택, 검색 전략, 포함·제외 기준, 검색 기록이 여전히 필요합니다. 자연어 질의 한 번이 완전하고 재현 가능한 체계적 검색은 아닙니다. 기능 범위는 OpenAlex 연구 탐색을 참고하세요.
6. 발견과 연구 진행 상황을 Zotero 노트로 저장하기
읽기 세션이 끝나면 채팅 기록 이상의 것이 필요합니다. 확립된 내용, 검증할 내용, 다음에 읽을 자료를 담아 작업을 재개할 수 있는 노트를 원합니다.
BibGenie에 논의 정리를 요청한 뒤 저장 전에 내용을 검토합니다. 한 논문에 관한 노트는 그 항목에 첨부된 하위 노트가 될 수 있습니다. 논문 간 비교와 프로젝트 진행 상황은 독립 노트가 더 적합합니다. 그래야 종합 내용이 단일 논문에서 나온 것처럼 보이지 않습니다.
Turn our discussion of RAG answer faithfulness into a research progress note.

Include:
1. The current question and material actually used in this session;
2. Findings checked against the original sources, with citations;
3. Tentative interpretations and unresolved disagreements;
4. Questions to verify and reading tasks for the next session.

Do not automatically label discussed content as "Verified."
Do not describe OpenAlex candidates as papers we have read in full.
Show the draft first; do not save it yet.
검토하고 수정한 뒤 이렇게 요청할 수 있습니다. ‘위 진행 노트를 “RAG 답변 충실도: 읽기 진행 상황”이라는 제목의 독립 Zotero 노트로 저장해 줘. 논문에 첨부하지 마.’ 단일 논문 요약이라면 의도한 상위 항목을 지정합니다.
또는 마지막 AI 텍스트 답변의 노트로 저장으로 그 답변을 저장할 수 있습니다. 대화가 길면 먼저 통합 노트를 요청합니다. 저장 후 Zotero에서 위치, 출처 링크, 표를 확인해 연구 기록으로 쓸 수 있는지 점검합니다. 두 방법과 상위 항목 처리 방식은 노트로 저장을 참고하세요.
프로젝트로 돌아오면 새로 읽은 논문과 함께 @로 진행 노트를 새 대화에 추가할 수 있습니다. 그러면 미해결 질문, 이전 판단, 새 자료를 함께 검토할 수 있습니다.
7. 라이브러리가 커지면 컬렉션과 태그 재점검하기
논문이 쌓이면 서로 다른 단계에서 만든 컬렉션이 겹치고, 같은 뜻의 태그에 다른 철자가 쓰이며, 과거 분류가 현재 연구 질문과 맞지 않을 수 있습니다. 예를 들어 가져온 논문에 RAG와 retrieval-augmented generation이 모두 쓰일 수 있으며 이 태그를 합칠지는 자신의 정리 방식에 달려 있습니다.
저는 BibGenie의 라이브러리 정리 기능으로 기존 구조를 살펴보고 변경을 제안받습니다. 내장된 Library Management 스킬은 컬렉션, 태그, 항목 정보를 읽고 정리를 지원할 수 있습니다. 스킬 페이지로 직접 전환하지 않고 자연어로 목표를 설명합니다.
매번 분류를 새로 구축하기보다는 유용한 기존 구조를 보존하며 특정 불일치를 해결하는 것이 우선입니다.
Inspect the papers in my current project collection, their existing tags,
and their collection memberships.

Propose a limited organization plan:
1. Identify potentially synonymous tags and differences in capitalization or spelling;
2. List proposed standardized names, affected item counts, and reasons;
3. Prefer existing collections when suggesting suitable subcollections for unfiled papers;
4. List uncertain cases separately rather than forcing a classification.

Do not assume similar names mean the same thing.
Show the plan first. Do not make changes, delete items, or overwrite metadata.
검토 후에는 실행할 변경을 지정합니다. 예를 들어 같은 뜻임이 확인된 태그를 통일하거나 다른 소속은 유지하면서 선택한 논문을 기존 하위 컬렉션에 추가합니다. 쓰기 승인을 요청하면 정확한 작업과 대상 항목을 살펴본 뒤 Zotero에서 결과를 확인합니다.
컬렉션 변경, 태그 병합, 메타데이터 수정을 하나의 광범위한 작업으로 묶지 않고 누락된 DOI, 초록, 기타 필드는 별도로 처리합니다. 기능과 경계는 라이브러리 관리를 참고하세요.
유지하는 연구 습관
이 워크플로 내내 저는 BibGenie의 출력을 검토하고 수정할 연구 자료로 취급합니다. 판단을 채택할지는 근거, 연구 설계, 프로젝트 요구 사항에 달려 있습니다.
다음 습관을 지킵니다.
- 자료 범위를 정의합니다. 선택 구절, 첨부파일, 컬렉션, 외부 검색 중 무엇인지 지정합니다. 원문 질문 전에 읽을 수 있는 원문이 있는지 확인합니다.
- 불확실성을 보존합니다. 완결된 답변을 만들기 위해 ‘보고되지 않음’, 근거 부족, 비교 불가능한 결과를 모델에 채우라고 요청하지 않습니다.
- 활용할 판단을 검증합니다. 특히 정의, 실험 데이터, 한계, 논문 간 종합을 확인합니다.
- 근거와 해석을 분리합니다. 독서 노트에서 출처, AI 요약, 자신의 판단을 구분합니다.
- 모델로 보내는 내용을 통제합니다. 미발표 원고, 제한 자료, 민감 정보는 먼저 권한과 모델 요청 경로를 확인합니다. 채팅과 색인이 로컬에 저장된다고 클라우드 모델이 요청에서 아무 자료도 받지 않는 것은 아닙니다.
이것이 제가 Zotero AI 플러그인에 기대하는 연구 방식입니다. 기존 논문에서 시작해 구체적인 질문을 중심으로 자료를 정리하고 출처를 다시 찾아 주장을 검증하며 확인된 이해를 자신의 연구 기록에 남기는 것입니다.
워크플로를 체험하려면 읽고 있는 논문과 명확히 해야 할 질문 하나로 시작하세요. 설치는 BibGenie 설정 가이드를 참고하세요. 플러그인 조합을 고르고 있다면 2026년 추천 Zotero 플러그인을 보세요.