我如何用 BibGenie 完成文獻閱讀與研究筆記
以文獻綜述為例,介紹如何使用 Zotero AI plugin BibGenie 檢索文獻、精讀論文、核對來源、比較研究方法,將閱讀進度儲存為 Zotero 筆記,並整理集合與標籤。
文獻綜述中,花時間的往往不只是閱讀一篇新論文。更常見的情況是:我記得某篇文章討論過一個重要問題,卻無法立即找到;幾篇論文使用了相近術語,實際評估的物件卻不相同;一段總結看起來合理,回到原文後才發現遺漏了關鍵條件。
我希望 Zotero AI plugin 幫助處理的,正是這些與具體文獻、研究問題和證據有關的工作。對我來說,BibGenie 的價值在於把提問、檢索和來源核查放在同一個 Zotero 工作環境中,讓一次回答能夠繼續成為下一步閱讀的起點。
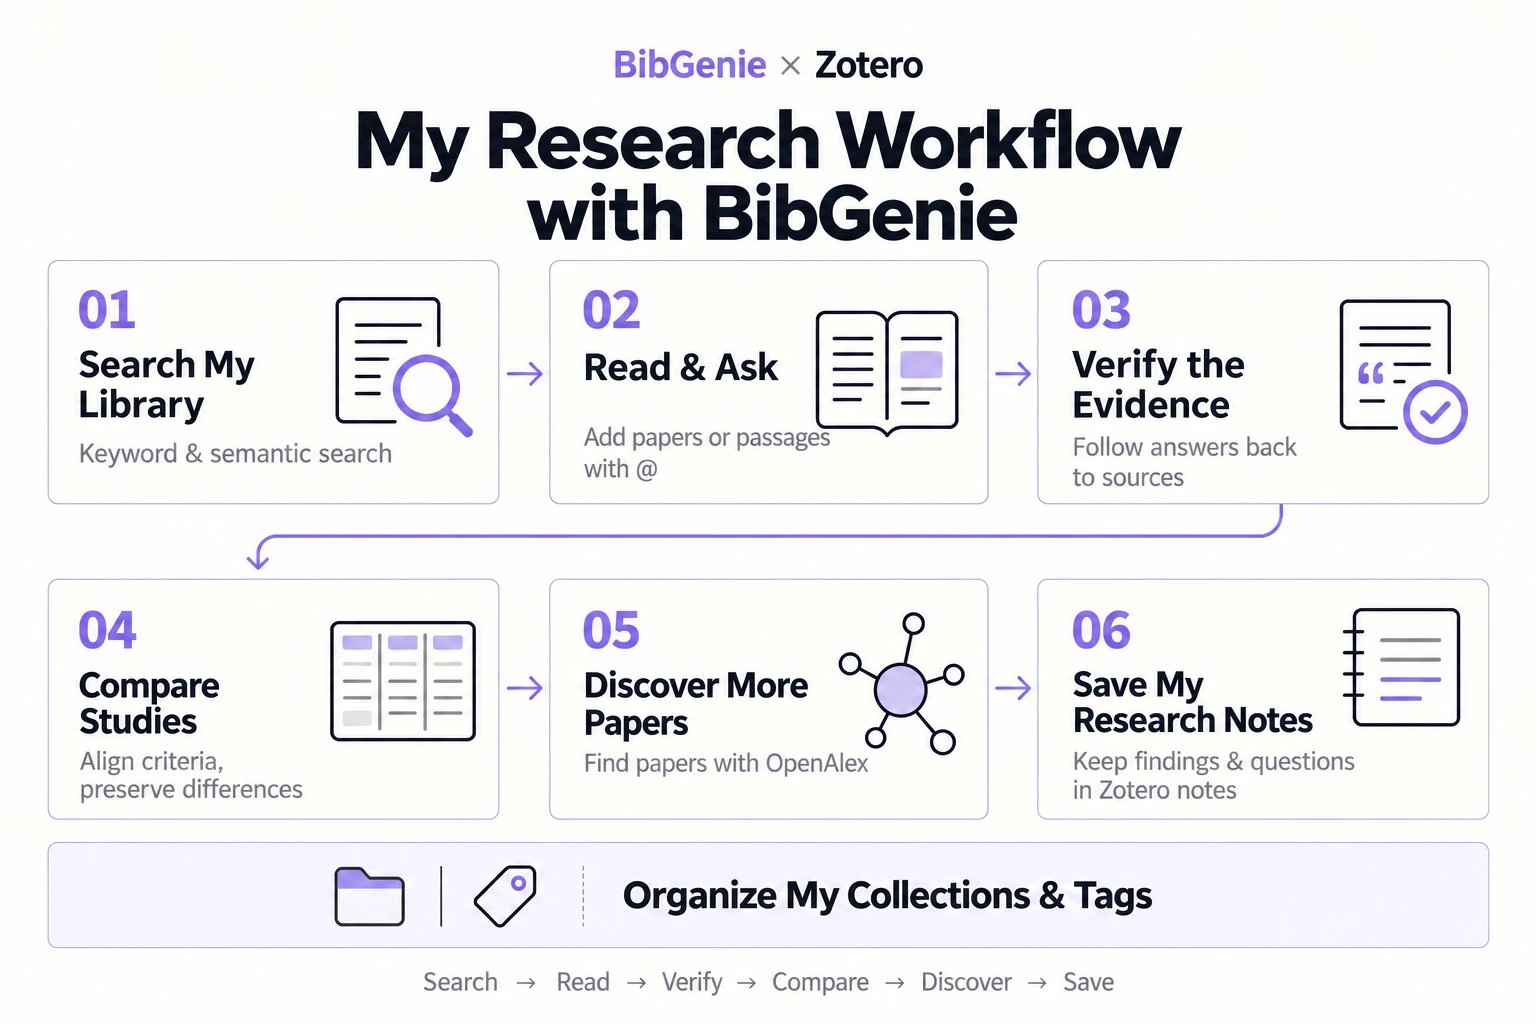
從研究問題到閱讀筆記的工作流概覽;集合與標籤整理按文獻積累情況另行開展。
關於本文
本文由 BibGenie 團隊編寫,以團隊成員的研究工作視角介紹使用方法。下文以“檢索增強生成中的回答忠實性評估”為貫穿示例,提示詞可按實際課題調整;示例不代表已經完成的研究實驗,也不預設檢索結果或論文結論。
作者以英文撰寫本文,英文版為原稿,本頁為中文譯文。
一、先從一個研究問題出發,找回已有文獻
當我準備梳理一個主題時,通常會先檢查 Zotero 中已經積累的材料。例如,這次的問題是:檢索增強生成(RAG)系統如何評估回答是否受到檢索證據的支援?
直接搜尋 faithfulness 可以找到一部分文獻,但相關研究也可能使用 groundedness、attribution 或 citation correctness 等表達。這些術語未必等價,相關工作也未必包含完全相同的關鍵詞。因此,我會結合關鍵詞檢索與語義檢索,先獲得候選文獻,再逐一確認它們與研究問題的關係。
請先在我的 Zotero 文獻庫中查找與以下問題相關的論文:
RAG 系統如何評估生成回答是否得到檢索證據的支持?

請結合關鍵詞和語義檢索,並關注 faithfulness、groundedness、
attribution、citation correctness 等相關表述,但不要預設它們含義相同。

列出候選論文的標題、年份,以及根據標題和摘要判斷的相關性。
請明確哪些資訊來自摘要,不要將其表述為已核實的全文結論。
本輪只檢索已有文獻,不進行外部檢索,也不修改文獻庫。此時,我要得到的是一份待閱讀的候選清單。我會根據摘要檢查研究物件是否匹配:論文是在評價回答的事實正確性、回答與給定證據的一致性,還是引用本身的準確性?如果這些問題沒有區分清楚,後面的比較很容易失去共同基礎。
自動更新的語義索引
BibGenie 會自動為文獻建立和更新語義索引,通常不需要手動管理,讓我可以直接圍繞研究問題檢索已有材料。目前索引主要基於條目的標題和摘要,幫助發現用詞不同但主題相關的文獻,並不等同於 PDF 全文語義檢索。因此,我會把結果作為候選清單,涉及方法和結論的判斷仍需繼續閱讀全文。具體機制見 語義索引說明。
二、把具體論文加入對話,再討論方法與結論
確定優先閱讀的論文後,我會直接在 BibGenie 輸入框中輸入空格加 @,再輸入論文標題,從搜尋結果中選擇對應文獻。選擇後,文獻會以上下文塊的形式加入輸入框,我可以接著輸入問題,也可以繼續新增其他論文或筆記。
這一步不需要先開啟 Reader。討論方法和實驗結果時,我會確保所選文獻有關聯的可讀全文;如果只能讀取標題、摘要等元資料,就先將問題限定在這些材料能夠支援的範圍內。其他新增方式見 新增上下文。
我通常不會在第一輪就要求“寫一篇綜述”,而是先把單篇研究的邏輯拆開:研究問題是什麼,方法針對什麼物件,實驗支援了哪些結論,又有哪些侷限。
請基於我加入的這篇論文全文,按以下結構梳理:
1. 研究問題,以及作者如何界定回答忠實性或相關概念;
2. 評估單位:整段回答、句子、事實陳述,還是引用;
3. 評估所依據的證據、標註方式與評價指標;
4. 實驗設定和主要發現;
5. 作者明確討論的侷限。

請為關鍵表述提供可核對的來源引用。
區分作者原文結論和你的解釋;材料沒有說明的部分,請標記為“未說明”。
這份結構化梳理用於建立閱讀框架。隨後,我會圍繞真正影響研究判斷的細節繼續追問。例如,如果一種指標以檢索到的上下文為參照,我會檢查它是否也評價檢索結果本身的正確性;如果沒有,便不能直接把該指標理解為對回答整體事實正確性的保證。
對於定義、公式附近的說明或實驗設定,我會進一步在 Reader 中選中相關段落,透過 Add to Chat 加入對話後提問。直接 @ 文獻適合從整篇研究開始,Reader 選區則適合把問題限定到明確片段,二者可以在同一閱讀過程中配合使用。
三、點選引用回到原文,檢查回答是否成立
閱讀 AI 總結時,我最關心的不是表達是否流暢,而是其中的關鍵判斷能否得到原文支援。準備寫入筆記的定義、實驗結果或方法侷限,我都會回到來源核對。
BibGenie 會在適用的回答中提供來源引用。對於帶有效定位資訊的文件引用,點選後可以返回對應材料及相關位置。這裡需要區分:指向證據的引用,與指向 Zotero 條目、附件或筆記的物件連結,作用並不相同。後者方便繼續操作,但不能僅憑一個可點選的論文標題,就認為旁邊的判斷已經有了原文依據。
我會重點核對以下內容:
| 核查物件 | 我會檢查什麼 |
|---|---|
| 概念定義 | 回答是否保留了作者的限定條件,是否混用了相關術語 |
| 實驗結果 | 數值、資料集、基線與實驗條件是否對應 |
| 方法侷限 | 是作者明確報告的限制,還是 AI 自行推斷 |
| 綜合判斷 | 原文是否足以支援該判斷,是否需要補充其他來源 |
如果回答把不同層次的問題合併了,我會直接指出需要修正的地方:
請重新核對引用處的定義。
這裡討論的是“回答與給定上下文的一致性”,還是“回答在現實世界中的事實正確性”?
請基於原文說明二者的邊界,並據此修訂剛才的總結。
如果原文不足以支持某個判斷,請明確撤回或保留為待驗證問題。
引用提供了回到來源的路徑,但仍需要檢查來源是否真正支援回答。具體的來源型別與跳轉方式,可以參閱 BibGenie 引用與來源導航 和 PDF 段落級引用。
四、比較多篇文獻,先統一比較維度
完成幾篇重點文獻的閱讀後,我會把相關附件和已有筆記加入同一段對話,開始橫向比較。
這裡最容易出現的問題,是把形式相似的結果直接放在一起。例如,兩篇論文都報告一個分數,但評估單位、證據範圍和資料集並不一致。表格可以幫助整理材料,卻不能自動消除研究設計之間的差異。
因此,我會先指定比較維度,並要求保留“不適用”和“未報告”的位置。
請只依據我加入的論文和閱讀筆記,比較這些研究的評估設計。

表格列為:論文、概念定義、評估單位、證據來源、標註或判定方式、
使用的資料集、主要侷限、對應來源引用。

沒有報告的內容寫“未報告”,不適用於該研究的維度寫“不適用”。
不要補全缺失資訊,也不要對不同資料集、不同設定下的分數直接排名。

表格後請分別列出:
1. 可以在現有材料中確認的共同點;
2. 研究之間尚不能直接比較的部分;
3. 我需要回到全文進一步核查的問題。
得到比較表後,我會逐項複核對研究判斷有影響的單元格,再形成自己的綜合意見。如果某篇論文只有摘要或筆記可用,就應將這一材料限制保留在比較結果中。
整理閱讀筆記時,我也會保留三個層次:作者報告了什麼、AI 如何歸納、我如何理解。這樣,後續撰寫綜述時,可以重新檢查論證依據,而不必把一段語言完整的總結當成最終結論。
五、用 OpenAlex 補充檢索,檢查已有材料的覆蓋範圍
本地文獻庫反映的是已經收集的材料,不等於一個主題的全部研究。完成初步閱讀後,我會用 OpenAlex 補充檢索近期論文,並圍繞已確認相關的種子文獻探索引用關係。
我會明確要求把本地文獻和外部結果分開,避免把“檢索到一條學術記錄”誤認為“已經讀過這篇論文”。
請使用 OpenAlex 補充檢索 RAG 回答忠實性評估相關研究,
先返回 2025 年以來最多 10 條候選記錄。

請列出標題、年份、來源、DOI 或其他可用標識符,
並說明基於可用元資料判斷的相關性。
如果資訊不足以判斷,請明確標記。

請與本輪已檢索的 Zotero 文獻區分,標明可以確認的重複記錄;
無法確認是否重複的記錄請單獨列出。暫不匯入文獻庫。
對值得繼續追蹤的論文,我會要求查詢引用它的文獻、它引用的文獻或相關記錄。引用次數可以作為探索線索,但我不會單憑引用數決定論文質量或閱讀優先順序。
OpenAlex 主要提供學術元資料與引用關係。要判斷方法是否適合當前課題,仍需要取得並閱讀全文。核對標題、DOI 和研究範圍後,我才會決定哪些候選文獻值得匯入 Zotero,並繼續前面的精讀與核查過程。
這一步適合做探索性補充。如果任務是系統綜述,仍需要按照研究領域制定資料庫選擇、檢索式、納入排除標準和檢索記錄,不能把一次自然語言檢索視為完整、可復現的系統檢索。功能範圍見 OpenAlex 學術檢索。
六、將閱讀結論與研究進度儲存為 Zotero 筆記
結束一輪閱讀時,我希望保留下來的不只是聊天記錄,而是一份下次開啟後能夠繼續工作的研究筆記:目前確認了什麼,哪些判斷仍需核查,接下來應該閱讀哪些材料。
因此,我會先讓 BibGenie 整理本輪討論,再審閱準備儲存的內容。單篇論文的閱讀結論可以作為該文獻的子筆記;跨文獻比較與課題進度則更適合儲存為獨立筆記,避免讓綜合判斷看起來都來自同一篇論文。
請將本輪關于 RAG 回答忠實性評估的討論整理為研究進度筆記。

請包括:
1. 當前研究問題與本輪實際使用的材料;
2. 已經回到原文核實的結論及來源引用;
3. 暫定解釋與尚未解決的分歧;
4. 待核查問題和下一輪閱讀任務。

不要將討論過的內容自動標記為“已核實”,
也不要將 OpenAlex 候選記錄寫成已經閱讀全文的材料。
先展示筆記草稿,暫不儲存。
審閱並修訂後,我可以直接要求:“將上面的研究進度儲存為一篇獨立 Zotero note,標題為『RAG 回答忠實性評估:閱讀進度』,不要掛到某篇論文下。”如果是單篇論文總結,則明確指定對應的父條目。
也可以在最後一條 AI 文本回答上使用 Save as Note 按鈕,儲存當前這條回答。對較長的對話,我會先生成一份完整的筆記版本,再儲存。儲存後,我會在 Zotero 中檢查筆記歸屬、來源連結和表格等內容,確認它能夠作為後續研究記錄使用。兩種儲存方式與筆記歸屬見 儲存為筆記。
下一次繼續這個課題時,我可以透過 @ 把已儲存的研究進度筆記重新加入對話,再新增新讀的論文。這樣,待驗證問題、已有判斷和新材料能夠在同一輪討論中銜接起來。
七、文獻積累之後,重新梳理集合與標籤
隨著同一主題的文獻持續積累,不同階段建立的 collection(集合)可能出現交叉,同義 tag(標籤)採用了不同寫法,早期分類也未必還能反映當前研究問題。例如,幾次匯入的文獻可能分別使用 RAG 和 retrieval-augmented generation,但是否需要合併,仍取決於我自己的分類習慣。
這時,我會使用 BibGenie 的文獻庫整理能力,先檢查現有結構,再提出調整建議。BibGenie 內建了 Library Management 文獻庫管理技能,可以讀取集合、標籤與條目資訊,並協助完成集合組織、標籤管理等操作。我可以直接用自然語言說明整理目標,不需要手動切換到某個技能頁面。
我更關心的是保留既有組織方式,並修正具體的混亂之處,而不是每次都重新建立一套分類。
請檢查當前課題集合中的文獻,以及它們使用的現有標籤和集合關係。

請提出一個小範圍整理方案:
1. 找出可能同義、僅大小寫不同或拼寫不一致的標籤;
2. 列出建議統一的名稱、涉及條目數量和理由;
3. 對尚未歸入合適子集合的文獻,優先建議已有集合;
4. 無法判斷的條目單獨列出,不強行分類。

不要僅憑名稱相近就認定標籤同義。
先展示方案,不執行任何修改,不刪除條目,也不覆蓋元資料。
審閱後,我會指定本次確認要執行的調整,例如統一一組已經確認同義的標籤,或將選定文獻加入已有子集合,同時保留其他集合關係。出現寫入審批時,我會核對具體操作及受影響條目;執行後再回到 Zotero 檢查結果。
對於缺失 DOI、摘要或其他欄位,我會單獨處理,避免把集合調整、標籤合併和元資料修訂混在一次大範圍操作中。整理能力與使用邊界見 文獻庫整理。
我會保留的研究習慣
在這套流程中,我把 BibGenie 的輸出作為可繼續檢查和修訂的研究材料。是否採納一個判斷,取決於原文證據、研究設計和當前課題的要求。
實際使用時,我會保留以下習慣:
- 明確材料範圍。 提問時說明是當前選區、指定附件、某個集合,還是外部學術檢索;需要全文判斷時,先確認全文可讀。
- 保留不確定性。 對“未報告”“證據不足”和“無法直接比較”的內容,不要求模型補成一個完整答案。
- 核查準備採納的判斷。 尤其是定義、實驗資料、方法侷限和跨文獻綜合意見。
- 區分材料與解釋。 閱讀筆記中保留來源、AI 歸納和個人判斷,便於後續複查。
- 控制資料傳送範圍。 對未公開稿件、受限制材料或涉及敏感資訊的內容,先確認使用許可權和模型請求路徑;聊天記錄與索引儲存在本地,不等於雲端模型不會接收請求中的材料。
這也是我希望 Zotero AI plugin 融入研究過程的方式:從已有文獻出發,圍繞具體問題組織材料,透過來源引用反覆核查,再把確認過的理解留在自己的研究記錄中。
如果你準備嘗試這套流程,可以從一篇正在閱讀的論文、一個需要澄清的問題開始。BibGenie 安裝指南 提供上手入口;如果還在選擇適合自己的外掛組合,可以參考 2026 年 Zotero 外掛推薦。