BibGenieを使った私の文献読解と研究ノートの作り方
ZoteroのAIプラグインBibGenieで、文献検索、精読、出典確認、研究間の比較、OpenAlexによる追加検索、研究ノートの保存を行うワークフローを紹介します。
文献レビューでは、新しい論文を読むことだけが作業ではありません。重要な問題を扱っていた論文を思い出しても、すぐには見つからないことがあります。似た用語を使っていても、実際には異なる対象を評価している研究もあります。もっともらしい要約を原文と照合したところ、重要な条件が抜けていることに気づく場合もあります。
私が ZoteroのAIプラグイン(Zotero AI plugin) に支援してほしいのは、このように個々の論文、研究課題、根拠を扱う作業です。BibGenieの価値は、質問、検索、出典確認を同じZoteroの環境で進められることにあります。一つの回答を、次の読解の出発点にできるからです。
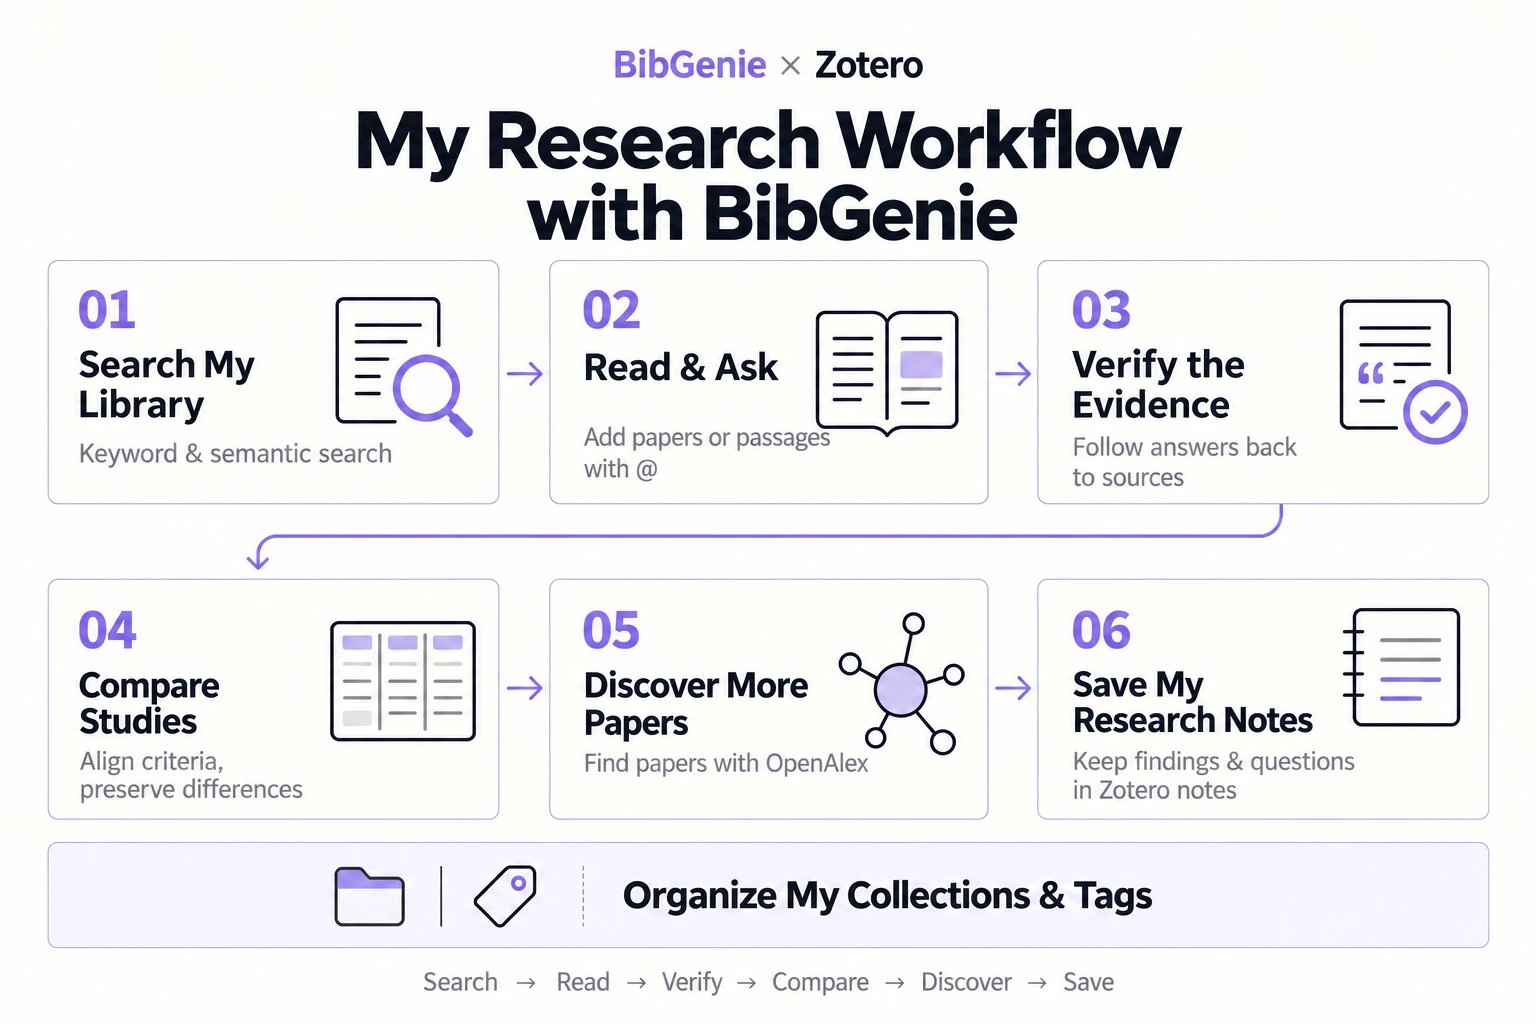
研究課題から読書ノートまでの流れ。コレクションとタグの整理は、文献の蓄積に応じて別途行います。
この記事について
本記事はBibGenieチームが執筆し、チームメンバーの研究活動の視点から使い方を紹介するものです。著者は英語で執筆しており、英語版が原文、本ページはその日本語訳です。検索拡張生成における回答の忠実性評価を一貫した例として用います。プロンプトは自身の研究に合わせて調整できます。例示は完了した研究実験の報告ではなく、特定の検索結果や研究上の結論を前提としません。
1. 研究課題を出発点に、手元の文献を探し直す
あるテーマを調べるとき、私はまずZoteroに保存済みの資料を確認します。ここでの問いは、検索拡張生成(RAG)システムでは、回答が検索された根拠によって支持されているかを、どのように評価するのかです。
faithfulness で検索すれば一部の論文は見つかりますが、関連研究では groundedness、attribution、citation correctness といった表現も使われます。これらは必ずしも同義ではなく、関連する研究が同じ語彙を使うとも限りません。そこでキーワード検索と意味検索を組み合わせて候補を集め、それぞれと研究課題との関係を確かめます。
まず、私のZoteroライブラリで次の問いに関連する論文を探してください。
RAGシステムは、生成した回答が検索された根拠によって支持されているかを、どのように評価しますか。

キーワード検索と意味検索を組み合わせてください。faithfulness、groundedness、
attribution、citation correctnessを考慮しつつ、同じ意味とは仮定しないでください。

タイトル、発表年、タイトルと抄録から判断した関連性を示してください。
抄録に基づく情報を明示し、全文で確認済みの知見として扱わないでください。
保存済みの資料だけを検索し、外部検索やライブラリの変更は行わないでください。この時点で必要なのは、これから読む候補のリストです。抄録を読み、事実としての正確性、与えられた根拠との整合性、引用の正確性のどれを評価しているかを区別します。この区別が曖昧なままでは、その後の比較に共通の土台がなくなってしまいます。
自動更新される意味検索インデックス
BibGenieは意味検索用インデックスを自動で作成・更新するため、通常は手動で管理せずに研究課題から検索を始められます。主に文献アイテムのタイトルと抄録を利用し、表現が異なっていてもテーマの近い論文を探します。PDF全文を対象とした意味検索ではありません。結果は候補として扱い、方法や結論の判断には全文を読みます。仕組みは意味検索インデックスで説明しています。
2. 論文を会話に追加し、方法と結果を読み解く
読む論文が決まったら、BibGenieの入力欄で スペースに続けて @ を入力し、論文タイトルを検索して該当する結果を選びます。論文はコンテキストのブロックとして入力欄に追加されます。そのまま質問を書いたり、別の論文やノートを追加したりできます。
先にリーダーで開く必要はありません。方法や実験結果を検討する際は、選んだアイテムに読み取り可能な全文が添付されていることを確認します。タイトルや抄録などのメタデータしかない場合は、その資料から判断できる範囲に質問を限定します。ほかの追加方法はコンテキストの追加を参照してください。
最初から文献レビュー全体の執筆を求めるのではなく、一つの研究の論理を整理します。研究課題、方法の評価対象、実験が支持する知見、限界を順に確かめるためです。
追加した論文の全文に基づいて、次の点を整理してください。
1. 研究課題と、回答の忠実性または関連概念の定義。
2. 評価単位:回答全体、文、事実に関する主張、引用のいずれか。
3. 使用する根拠、アノテーション手順、評価指標。
4. 実験設定と主な知見。
5. 著者が明示的に論じている限界。

主要な記述には確認可能な出典を付けてください。
著者の結論とあなたの解釈を区別してください。
資料に説明がない点は「記載なし」としてください。
この整理を読解の枠組みにして、解釈に影響する細部をさらに質問します。例えば、検索されたコンテキストを参照する評価指標であれば、そのコンテキスト自体の正確性も評価しているかを確かめます。そうでなければ、その指標だけで回答全体の事実としての正確性を保証することはできません。
定義、数式の周辺説明、実験の詳細については、リーダーで該当箇所を選択し、Add to Chat で追加してから質問します。@ で論文を追加すれば研究全体について検討でき、選択範囲を追加すれば特定の記述に問いを絞れます。同じ読解の中で両方を使い分けます。
3. 引用から原文に戻り、回答が根拠に支えられているか確かめる
AIによる要約を読むときは、主要な主張が原文で裏付けられているかを重視します。定義、実験結果、方法の限界をノートに取り入れる前に、必ず出典に戻ります。
BibGenieは、対応する場面で出典への引用を付けます。有効な位置情報を持つ文書引用であれば、元の資料と該当箇所に戻れます。ここで、根拠を示す引用と、Zoteroのアイテム・添付ファイル・ノートへのリンクは役割が異なります。後者は作業の継続に便利ですが、論文タイトルをクリックできるだけでは、その横の主張が裏付けられているとはいえません。
| 確認対象 | 確かめること |
|---|---|
| 定義 | 著者の限定条件が保たれ、関連用語が区別されているか |
| 実験結果 | 数値、データセット、比較手法、実験条件が一致しているか |
| 方法の限界 | 著者の明示した限界か、AIによる推論か |
| 総合的な解釈 | その出典だけで判断を支えられるか、追加資料が必要か |
異なる問いを混同した回答には、修正を求めます。
引用箇所の定義をもう一度確認してください。
ここで扱っているのは、与えられたコンテキストとの整合性ですか。
それとも現実世界における事実としての正確性ですか。
原文に基づいて違いを説明し、先ほどの要約を修正してください。
根拠のない主張は撤回するか、検証が必要な問いとして明示してください。引用は出典に戻る経路です。その出典が回答を実際に支持するかは、引き続き確認する必要があります。対応する出典と移動方法はBibGenieの引用と出典ナビゲーションおよびPDFの段落単位の引用で説明しています。
4. 共通の観点を定めて複数の研究を比較する
主要な論文を数本読んだら、添付ファイルと既存のノートを同じ会話に追加して比較します。
陥りやすいのは、見かけの似た結果をそのまま比較することです。二つの論文がスコアを報告していても、評価単位、根拠の範囲、データセットが異なる場合があります。表にすれば整理はできますが、研究設計の違いまで解消されるわけではありません。
そこで比較する観点を先に指定し、「該当なし」「報告なし」を残せるようにします。
追加した論文と読書ノートだけを使い、各研究の評価設計を比較してください。

表の列は、論文、概念の定義、評価単位、根拠の出典、
アノテーションまたは判定手順、データセット、主な限界、出典引用としてください。

情報が報告されていない場合は「報告なし」、適用できない観点には「該当なし」と記載してください。
欠けた情報を補ったり、異なるデータセットや実験設定のスコアをそのまま順位付けしたりしないでください。

表の後に、次を分けて示してください。
1. 現在の資料で確認できる共通点。
2. まだ直接比較できない点。
3. 全文でさらに確認すべき問い。
自分の解釈をまとめる前に、その判断に影響する表の各項目を確認します。ある論文について抄録やノートしか利用できない場合、その資料上の限界を比較結果にも明示しておきます。
読書ノートでも、著者が報告したこと、AIによる要約、自分の解釈を区別します。後でレビューを書く際に、整った文章を最終結論とみなさず、根拠を再確認できるようにするためです。
5. OpenAlexでライブラリ外の文献を補足する
ローカルライブラリにあるのは収集済みの資料であり、そのテーマの研究全体ではありません。初期の読解を終えたら、OpenAlexで近年の論文を探し、関連する起点論文の引用関係を調べます。
ローカルの結果と外部の結果は明確に分けるよう指示します。書誌レコードが見つかったことと、その論文を読んだことは別だからです。
OpenAlexを使い、RAGの回答の忠実性評価に関する研究を追加で探してください。
まず2025年以降に発表された候補レコードを最大10件示してください。

タイトル、発表年、掲載誌・会議などの掲載先または情報源、DOIなどの利用可能な識別子を示してください。
利用可能なメタデータから関連性を説明し、情報が不十分な場合は明記してください。

この会話で検索したZoteroの論文と区別してください。
確認できる重複を示し、同一か判断できないものは別に列挙してください。
まだインポートしないでください。
有望な論文については、それを引用する研究、そこで引用されている研究、関連レコードを調べます。被引用数は探索の手掛かりになりますが、それだけで質や読む順番を決めることはしません。
OpenAlexが主に提供するのは学術メタデータと引用関係です。方法が自分の課題に適しているかを判断するには、引き続き全文の入手と読解が必要です。タイトル、DOI、研究範囲を確認してからZoteroに取り込む候補を決め、読解と検証を続けます。
これは探索的な補足検索です。システマティックレビューでは、分野に適したデータベースの選択、検索式、採用・除外基準、検索記録が別途必要です。自然言語による一度の検索を、網羅的かつ再現可能な系統的検索とみなすことはできません。機能の範囲はOpenAlexによる学術検索を参照してください。
6. 読解の結論と研究の進捗をZoteroノートに保存する
一回の読解を終えたとき、残したいのはチャット履歴だけではありません。何が確認でき、何が未検証で、次に何を読むかがわかり、次回すぐに作業を再開できるノートです。
まずBibGenieに議論を整理させ、保存する前に内容を確認します。単一論文についてのノートは、そのアイテムの子ノートとして保存できます。複数論文の比較や課題の進捗には、独立したノートが適しています。総合的な解釈を一つの論文の結論のように見せないためです。
ここまでのRAGの回答の忠実性に関する議論を、研究進捗ノートに整理してください。

含める内容:
1. 現在の研究課題と、このセッションで実際に使った資料。
2. 原文で確認した知見と出典引用。
3. 暫定的な解釈と未解決の見解の相違。
4. 検証すべき問いと次回の読解タスク。

議論した内容を自動的に「確認済み」にしないでください。
OpenAlexの候補を、全文を読了した論文として扱わないでください。
まず下書きを示し、まだ保存しないでください。
確認と修正を終えたら、「上の進捗を『RAGの回答の忠実性:読解の進捗』という独立したZoteroノートとして保存し、特定の論文には付けないでください」と頼めます。単一論文の要約なら、親となるアイテムを指定します。
最後のAIテキスト回答にある Save as Note ボタンでも、その回答を保存できます。長い会話では、先に一つのノートとして再整理させます。保存後はZoteroでノートの所属、出典リンク、表を確認し、研究記録として使えることを確かめます。両方の保存方法と親アイテムの扱いはノートとして保存で説明しています。
次回この課題を再開するときは、進捗ノートを @ で新しい会話に加え、新たに読んだ論文も追加できます。未解決の問い、これまでの判断、新しい資料を一緒に検討できます。
7. 文献の蓄積に合わせてコレクションとタグを見直す
同じテーマの文献が増えると、時期の異なるコレクションが重複したり、同じ意味のタグに表記揺れが生じたり、初期の分類が現在の問いに合わなくなったりします。例えば、インポートした論文に RAG と retrieval-augmented generation の両方が使われている場合でも、タグを統合すべきかは自分の整理方針次第です。
このような場面では、BibGenieで既存の構造を調べ、調整案を出させます。内蔵の Library Managementスキルは、コレクション、タグ、アイテム情報を読み取り、整理を支援できます。専用のスキル画面に手動で切り替えず、自然言語で目的を伝えられます。
私が重視するのは、既存の有用な構造を保ちながら具体的な不整合を修正することです。毎回分類全体を作り直す必要はありません。
現在の課題のコレクションにある論文、既存のタグ、所属コレクションを確認してください。

小規模な整理案を提案してください。
1. 同義の可能性があるタグと、大文字・小文字や綴りの違いを探す。
2. 統一する名称案、対象アイテム数、理由を示す。
3. 未整理の論文には、適切な既存のサブコレクションを優先して提案する。
4. 判断できないものは無理に分類せず、別に列挙する。

名称が似ているだけで同義と決めないでください。
まず案だけを示し、変更、アイテムの削除、メタデータの上書きは行わないでください。
案を確認してから、実行する変更を指定します。例えば、同義だと確認したタグを統一する、ほかの所属を保ったまま選択した論文を既存のサブコレクションに追加する、といった作業です。書き込みの承認が求められたら、具体的な操作と対象を確認し、実行後もZoteroで結果を確かめます。
欠けているDOI、抄録、その他のフィールドは別に扱います。コレクションの変更、タグの統合、メタデータの修正を一度の大規模な操作にまとめないためです。機能と範囲はライブラリ管理で説明しています。
続けている研究上の習慣
この流れでは、BibGenieの出力を確認・修正できる研究資料として扱います。ある判断を採用するかどうかは、根拠、研究設計、自分の課題の要件によって決めます。
- 対象資料を明確にする。 選択範囲、添付ファイル、コレクション、外部検索のどれを使うかを指定します。全文について質問する前に、全文が読めることを確認します。
- 不確実性を残す。 「報告なし」、根拠不足、直接比較できない結果を、回答を完成させるためだけに埋めさせません。
- 採用する判断を検証する。 特に定義、実験データ、限界、複数論文の総合的な解釈を確認します。
- 根拠と解釈を分ける。 出典、AIによる要約、自分の判断をノートでも区別します。
- モデルに送る資料の範囲を管理する。 未公開原稿、利用制限のある資料、機微情報は、先に権限とモデルへの送信経路を確認します。チャットとインデックスのローカル保存は、クラウドモデルにリクエスト内の資料が送られないことを意味しません。
私がZoteroのAIプラグインに期待するのは、手元の論文から始め、具体的な問いに沿って資料を整理し、出典に戻って主張を検証し、確認できた理解を自分の研究記録に残すことです。
この流れを試すなら、いま読んでいる論文と、明確にしたい問いを一つ用意すれば始められます。導入方法はBibGenieのセットアップガイドを参照してください。併用するツールを検討する場合は、2026年のおすすめZoteroプラグインも参考になります。